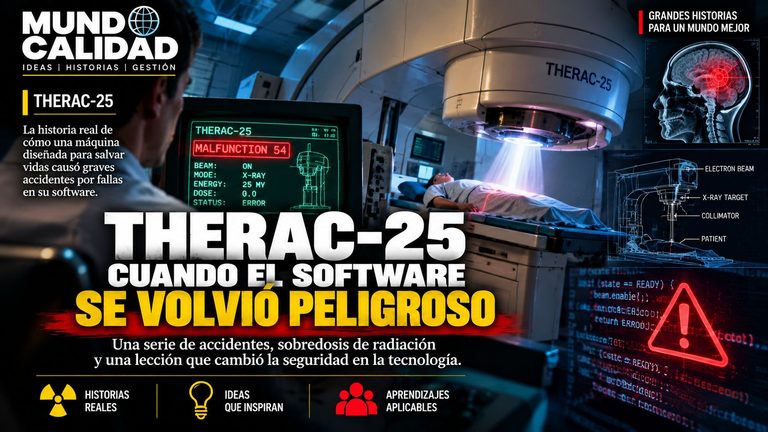
Una mujer ingresó a un centro médico en Georgia, Estados Unidos, para recibir un tratamiento contra el cáncer.
Frente a ella había una máquina moderna, sofisticada y controlada por computadora.
Su nombre era Therac-25.
Había sido diseñada para utilizar radiación de alta energía contra tumores.

Mundo Calidad · Caso de estudio
Therac-25: la máquina que confió demasiado en el software
Junio de 1985. Una mujer ingresa a un centro médico en Georgia, Estados Unidos, para un tratamiento contra el cáncer. Frente a ella, una máquina moderna, sofisticada y controlada por computadora. Todo parecía bajo control. Hasta que comenzó el tratamiento.
La paciente recibió una cantidad de radiación muy superior a la prevista. Al principio pudo parecer un accidente aislado, pero no lo era: en los meses siguientes aparecerían nuevos casos.
Esta es la historia de cómo una serie de accidentes cambió para siempre nuestra forma de pensar sobre software, automatización y seguridad.
Una máquina para combatir el cáncer
El Therac-25 era un acelerador lineal de radioterapia. Generaba radiación para destruir células cancerosas, y esta debía administrarse en el lugar correcto, durante el tiempo correcto y con la intensidad correcta. Una dosis calculada era tratamiento; una dosis incorrecta causaba lesiones graves.
Se desarrolló tras equipos anteriores, pero con una diferencia clave: el software tenía mucho más control. Era eficiente, moderno y parecía confiable. Faltaba una pregunta: ¿qué ocurriría si el software se equivocaba?
La confianza había cambiado de lugar
En los equipos anteriores, mecanismos físicos impedían configuraciones peligrosas: si algo no estaba bien colocado, la máquina no continuaba. En el Therac-25, parte de esas funciones pasó al software. La computadora verificaría, controlaría e impediría situaciones peligrosas. Parecía una evolución lógica, con una condición: el software tenía que funcionar correctamente.
Después llegó otro accidente
Durante 1985 y 1986 se registraron otros casos. Pacientes con tratamientos controlados recibieron sobredosis extremas. Algunos sufrieron lesiones severas; algunos murieron.
Descubrir la causa no era sencillo: la máquina podía funcionar bien una enorme cantidad de veces y fallar solo bajo ciertas circunstancias. Cuando un error ocurre siempre, es fácil de encontrar. Cuando depende de una combinación de acciones, tiempos y estados internos, puede permanecer oculto mucho tiempo.
El operador que trabajaba demasiado rápido
El operador introducía los datos, notaba que un parámetro debía corregirse, volvía sobre la información y continuaba. Esa secuencia rápida podía dejar descoordinados los procesos internos del software. La pantalla mostraba una configuración; la máquina estaba en otro estado. Es lo que en informática se conoce como condición de carrera: el resultado depende del orden y el momento exacto de los procesos.
Un operador lento o una prueba convencional podían no encontrarla. Uno experimentado, acostumbrado a la velocidad, sí podía desencadenarla. Paradójicamente, la experiencia del usuario ayudaba a revelar la falla oculta.
“Malfunction 54”
En marzo de 1986, en el East Texas Cancer Center, en Tyler, Texas, la computadora interrumpió el tratamiento de un paciente. En pantalla apareció:
Para el operador era uno de tantos códigos técnicos. No decía “peligro: posible sobredosis de radiación” ni transmitía la gravedad. El operador intentó continuar. Entonces el paciente sintió una intensa sensación, como una descarga. Algo había ocurrido en la sala, pero la consola no lo contaba con claridad.
La máquina decía una cosa. El paciente sentía otra.
La tecnología que debía controlar el peligro no logró comunicar lo que sucedía. Esto plantea una pregunta sobre cualquier tecnología:
Una alarma no es solo un sonido, un código no es solo un número. Una advertencia debe generar una acción. Si un mensaje crítico puede confundirse con una falla menor, hay un problema de diseño.
No existía un único “error mortal”
Los investigadores descubrieron algo más importante que una línea de código incorrecta. El problema no se explica con “un programador cometió un error”. Fue una combinación de:
- Diseño del sistema
- Interfaz con operadores
- Barreras de seguridad
- Mensajes de error
- Investigación de incidentes
- Comunicación
- Pruebas
- Confianza en la automatización
Cuando algo funciona 10.000 veces
Funciona cien veces, mil, diez mil. Y pensamos: “es segura”. Pero hay una enorme diferencia entre:
Que funcionara innumerables veces no eliminaba los defectos. Solo significaba que aún no se habían combinado las condiciones para hacerlos visibles.
El software tiene una característica particular
Cuando una pieza mecánica falla, solemos ver la causa: un engranaje roto, una correa cortada. El software puede funcionar hoy, mañana y durante meses, hasta que aparece un dato inesperado, una acción demasiado rápida, dos procesos simultáneos, un valor límite o una secuencia que nadie consideró. El defecto no nació ese día: ya estaba allí. Ese día aparecieron las condiciones para activarlo.
Automatizar no significa eliminar el error
Automatizamos buscando velocidad, precisión, repetibilidad, eficiencia y menos errores humanos, y todo eso puede lograrse. Pero algunos riesgos desaparecen y otros cambian.
Antes
Una persona introducía mal un dato.Después
Errores de programación, configuración e integración; fallas de sensores; problemas de interfaz; decisiones automáticas incorrectas; situaciones que nadie imaginó.La tecnología no elimina el riesgo. Lo transforma.
La pregunta que faltaba
Durante mucho tiempo la pregunta fue “¿funciona?”. En sistemas críticos no basta. También hay que preguntar “¿qué ocurre cuando falla?” y luego “¿qué impide que esa falla llegue hasta una persona?” Esa segunda pregunta obliga a pensar en barreras.
Una barrera detrás de otra
Con una única condición (“el software debe funcionar”), si falla, no queda nada más. En otro diseño, el software opera pero además hay:
Una falla individual ya no termina necesariamente en una consecuencia grave. Eso es defensa en profundidad: no confiar en que nada fallará, sino diseñar considerando que algo puede fallar.
Los pequeños incidentes también hablan
Un hospital vio una anomalía, otro algo distinto, un operador reportó un código extraño, un técnico no pudo reproducirlo. Por separado parecían hechos aislados; al conectarse apareció un patrón. Por eso los sistemas de gestión modernos vigilan incidentes, desviaciones, reclamos, casi accidentes, fallas repetitivas, alarmas y condiciones anormales. Cada una parece pequeña, pero juntas pueden estar intentando decir algo.
Las grandes fallas rara vez aparecen de la nada: un error que desaparece al reiniciar, una alarma que todos ignoran, una falla que “solo ocurre algunas veces”, un operador con una solución informal. La pregunta es si la organización está preparada para escucharlas.
Therac-25 y el mundo actual
Hoy confiamos decisiones a sistemas digitales constantemente: software médico, aviones, automóviles, bancos, industrias, infraestructuras, algoritmos, vigilancia, inteligencia artificial. Cada vez hay más decisiones en las que nadie controla directamente todo el proceso. Hay enormes beneficios, pero la pregunta es inevitable: ¿qué ocurre cuando el sistema decide mal? La respuesta no puede ser “esperamos que no ocurra”.
La inteligencia artificial enfrenta la misma pregunta
Cuanto más importante es la decisión que delegamos, mayor debe ser la preocupación por sus controles. No basta preguntar qué tan inteligente es el sistema:
- ¿Quién verifica su resultado?
- ¿Qué ocurre si se equivoca?
- ¿Cómo detectamos una decisión anormal?
- ¿Existe intervención humana?
- ¿Puede detenerse?
- ¿Queda registro de lo ocurrido?
- ¿Existen barreras independientes?
Una tecnología poderosa sin controles adecuados no necesariamente reduce el riesgo. Puede simplemente hacerlo menos visible.
Acerca del autor